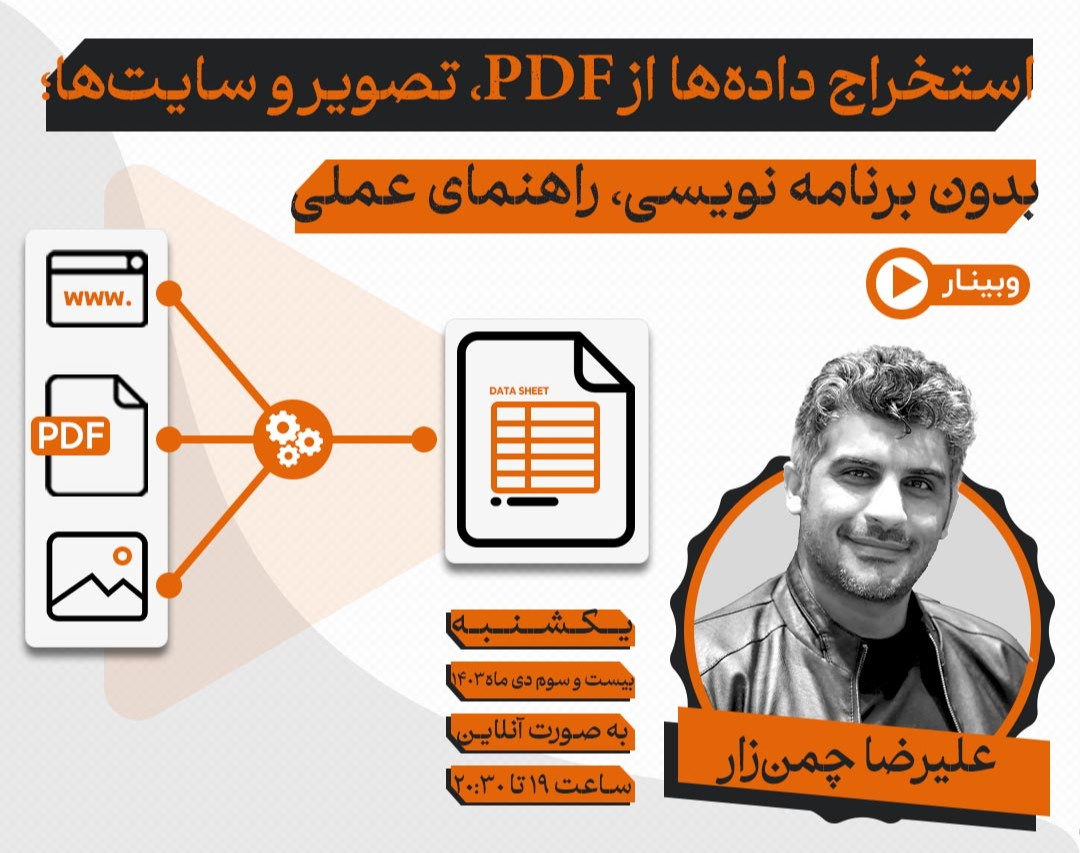
وبینار استخراج داده‌ها از PDF، تصویر و سایت‌ها؛ بدون برنامه‌نویسی
کد رویداد: 151456
علیرضا چمن‌زار
مدرس
علیرضا چمن‌زار
تحلیلگر داده در شرکت دقیقه و دانش آموخته سیاست‌گذاری اجتماعی
شروع وبینار 23 دی 1403 - ساعت 19:00
مدت وبینار
1 ساعت و 30 دقیقه
1
وبینار استخراج داده‌ها از PDF، تصویر و سایت‌ها؛ بدون برنامه‌نویسی
23 دی 1403
ساعت 19:00 تا 20:30
محل برگزاری آنلاین
این وبینار در نرم‌افزار اختصاصی برگزار می‌شود و امکان مشاهده بازپخش بعد از وبینار را ندارد!
مدرسه پردازش و تحلیل داده دقیقه
برگزارکننده
مدرسه پردازش و تحلیل داده دقیقه

استودیو هرف
برگزارکننده
استودیو هرف
استودیو هرف بستر خلاق فرهنگی مستقر در مرکز رشد دانشگاه علامه طباطبائی

مجله تحلیلی دقیقه
برگزارکننده
مجله تحلیلی دقیقه
دیتاژورنالیسم و روزنامه‌نگاری تحقیقی

Webinar Ad Banner 1
Webinar Ad Banner 2
دسته‌بندی‌ها
اشتراک‌گذاری

وبینار استخراج داده‌ها از PDF، تصویر و سایت‌ها؛ بدون برنامه‌نویسی
برگزار شده

وبینار استخراج داده‌ها از PDF، تصویر و سایت‌ها؛ بدون برنامه‌نویسی

مدت وبینار:
دسته‌بندی‌ها: 
ذخیره کردن
وبینار استخراج داده‌ها از PDF، تصویر و سایت‌ها؛ بدون برنامه‌نویسی

وبینار استخراج داده‌ها از PDF، تصویر و سایت‌ها؛ بدون برنامه‌نویسی
برگزار شده

وبینار استخراج داده‌ها از PDF، تصویر و سایت‌ها؛ بدون برنامه‌نویسی

مدت وبینار:
دسته‌بندی‌ها: 
ذخیره کردن
کد رویداد: 151456
توضیحات
نظرات
توضیحات

در عصر اطلاعات، داده‌ها نقش کلیدی در روایت‌های خبری ایفا می‌کنند. اما بسیاری از اطلاعات ارزشمند در قالب جداول و در منابعی مانند فایل‌های PDF و وب‌سایت‌ها پنهان شده‌اند که استخراج داده‌ها را زمان‌بر می‌کند و از سوی دیگر حجم بالای آنها می‌تواند دقت عمل را کاهش دهد و در نهایت خروجی نهایی حاوی اطلاعات ناقص یا غلط باشد. اگر می‌خواهید گزارش‌های خبری یا پژوهش‌های قوی‌تر، مستندتر و مبتنی بر واقعیت ارائه دهید، تسلط بر تکنیک‌های استخراج اطلاعات جدولی از این منابع ضروری است. این وبینار طراحی شده تا با زبانی ساده و کاربردی، شما را با مهم‌ترین مهارت‌ها و ابزارهای مورد نیاز برای این کار آشنا کند.

در این وبینار، خواهید آموخت که چگونه به طور مؤثر و کارآمد، داده‌های جدولی را از فایل‌های PDF و صفحات وب استخراج کنید. علیرضا چمن‌زار در این وبینار به بررسی ابزارهای متنوع و روش‌های مختلفی خواهد پرداخت تا شما بتوانید بر اساس نیاز و نوع منبع اطلاعات، بهترین گزینه را انتخاب کنید. این وبینار به شما کمک می‌کند تا از زحمت استخراج دستی اطلاعات رها شده و با صرف زمان کمتر، به انبوهی از داده‌های ارزشمند دسترسی پیدا کنید و به این ترتیب، گامی اساسی در ارتقای سطح گزارش‌های خود بردارید. تسلط بر استخراج داده‌ها، به شما این امکان را می‌دهد تا کیفیت گزارش‌های خود را به سطح بالاتری ارتقا دهید.
Webinar Ad Banner 1
Webinar Ad Banner 2
علیرضا چمن‌زار
مدرس
علیرضا چمن‌زار
تحلیلگر داده در شرکت دقیقه و دانش آموخته سیاست‌گذاری اجتماعی
شروع وبینار 23 دی 1403 - ساعت 19:00
مدت وبینار
1 ساعت و 30 دقیقه
1
وبینار استخراج داده‌ها از PDF، تصویر و سایت‌ها؛ بدون برنامه‌نویسی
23 دی 1403
ساعت 19:00 تا 20:30
مدرسه پردازش و تحلیل داده دقیقه
برگزارکننده
مدرسه پردازش و تحلیل داده دقیقه

استودیو هرف
برگزارکننده
استودیو هرف
استودیو هرف بستر خلاق فرهنگی مستقر در مرکز رشد دانشگاه علامه طباطبائی

مجله تحلیلی دقیقه
برگزارکننده
مجله تحلیلی دقیقه
دیتاژورنالیسم و روزنامه‌نگاری تحقیقی

محل برگزاری آنلاین
این وبینار در نرم‌افزار اختصاصی برگزار می‌شود و امکان مشاهده بازپخش بعد از وبینار را ندارد!
دسته‌بندی‌ها
اشتراک‌گذاری